CoT 언어모델은 데모로 무엇을 할지 받고, 중간 토큰으로 어떻게 계산한다. 그 대가는 직렬 나레이션이다. 중간 상태를 어휘에 투영하고, 다시 읽어야 다음 스텝이 간다. latent reasoning은 그 고리를 끊는다. 숨은 상태를 반복 변환하고, 답만 디코드한다. 문제는 두 줄기가 따로 컸다는 점이다. 컨텍스트에서 새 규칙을 배우는 쪽과, latent에서 반복 푸는 쪽이 잘 안 만났다.
BDH-CQ는 그 접합을 노린다. 데모는 재발 기억 를 갱신하고, 쿼리는 latent 워크스페이스 에서 반복 푼다. 중간 추론은 말로 안 푼다. 추론 때 파라미터도 안 건드린다. 학습에 평가 태스크 ID도 안 넣는다.
한 줄로 남기면 이렇다. ICL로 규칙을 붙잡고, latent 반복으로 실행하는 150M ARC 솔버 — 공개 평가 29.5% pass@2를 $0.00070/task에서 낸다는 논문 클레임.
어디서 왔나
출발점은 Dragon Hatchling (BDH)이다. ReLU-low-rank + linear attention, 고차원 양수 활성, 재발 associative state. BDH-CQ는 그 패밀리 위에 데모 조건 ICL + latent iterative solve 인터페이스를 얹은 시스템 이름이다. (세부 차원·업데이트 식은 proprietary라고 논문이 적는다.)
옆 줄기는 셋이다. (1) CoT LM — 데모 + 직렬 토큰 스크래치. (2) continuous-thought / recurrent-depth — Coconut, recurrent depth처럼 latent 반복은 있으나, “데모가 재발 기억에 규칙을 쓰는” ICL 결합이 이 논문의 축은 아니다. (3) ARC recursive solvers(HRM/TRM류) — latent 재귀는 강하지만, 평가 태스크 데모를 최적화에 넣고 태스크 ID를 쓰는 파이프라인이 흔하다. BDH-CQ는 추론 때 데모만으로 새 변환을 잡는 쪽을 강조한다.
ARC를 고른 이유는 단순하다. 소수 데모로 새 규칙을 주고하고, 출력이 정확히 검증되며, 여러 테스트 입력으로 “한 번 맞춘 것”과 “규칙을 일관 적용한 것”을 가를 수 있다.
ARC·Pareto·루프 그림
그림을 셋으로 나눈다. 먼저 ARC 데모가 무엇을 요구하는지, 다음 cost–accuracy Pareto에서 어디에 앉는지, 마지막에 기억→latent 루프 ELI5.
논문 Figure 1 — ARC 데모 태스크가 무엇을 요구하는가
위 패널부터 보면 된다. 데모 두 쌍과 쿼리 한 쌍이다. 입력은 회색 세로띠로 나뉜 두 이진 패널이고, 출력은 교집합에 해당하는 칸을 표시하는 식이다(논문 설명). 이름표로 “intersection”을 주지 않는다. 예제만으로 연산을 붙여야 한다. (arXiv HTML)
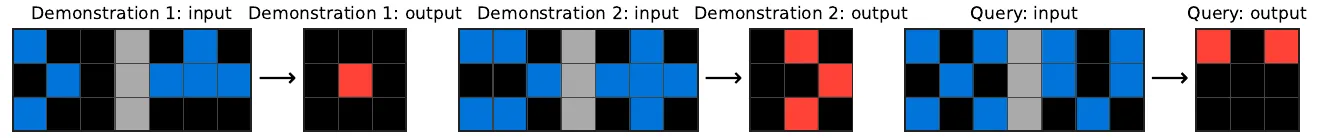
논문 Figure 1. ARC-AGI-1 training task 0520fde7. 왼쪽부터 Demonstration 1·2와 held-out Query — 각 쌍은 input→output. 변환 이름은 없고, 예제에서만 규칙을 읽는다(설명용으로 쿼리 정답 출력 포함).
여기서 보면 된다. BDH-CQ가 푸는 단위는 “긴 텍스트 추론”이 아니라 소수 데모로 붙인 시각 연산자다. 아래 메커니즘의 ·가 이 입력을 받는다.
논문 Figure 2 — cost–accuracy Pareto
가로축은 task당 비용(로그), 세로축은 ARC-AGI-1 pass@2다. 왼쪽 끝에 BDH-CQ 점이 있고, 기존 Pareto 곡선 안쪽(더 싸면서 비슷한 정확도)으로 뚫고 나간다는 그림이다. ARC Prize 리더보드(논문: 2026-08-04 수집) 기준.
가격표를 먼저 고정하자. 본문·abstract의 **57×**는 GPT-5.6 Luna (Low)를 ARC Prize가 보고한 인하 전 단가(0.008, 원래의 20%)를 쓰는 경우가 있어, 같은 그림에서 읽히는 배수는 ~11× 쪽으로 간다. 차트와 57×를 한 가격표로 섞지 말 것.
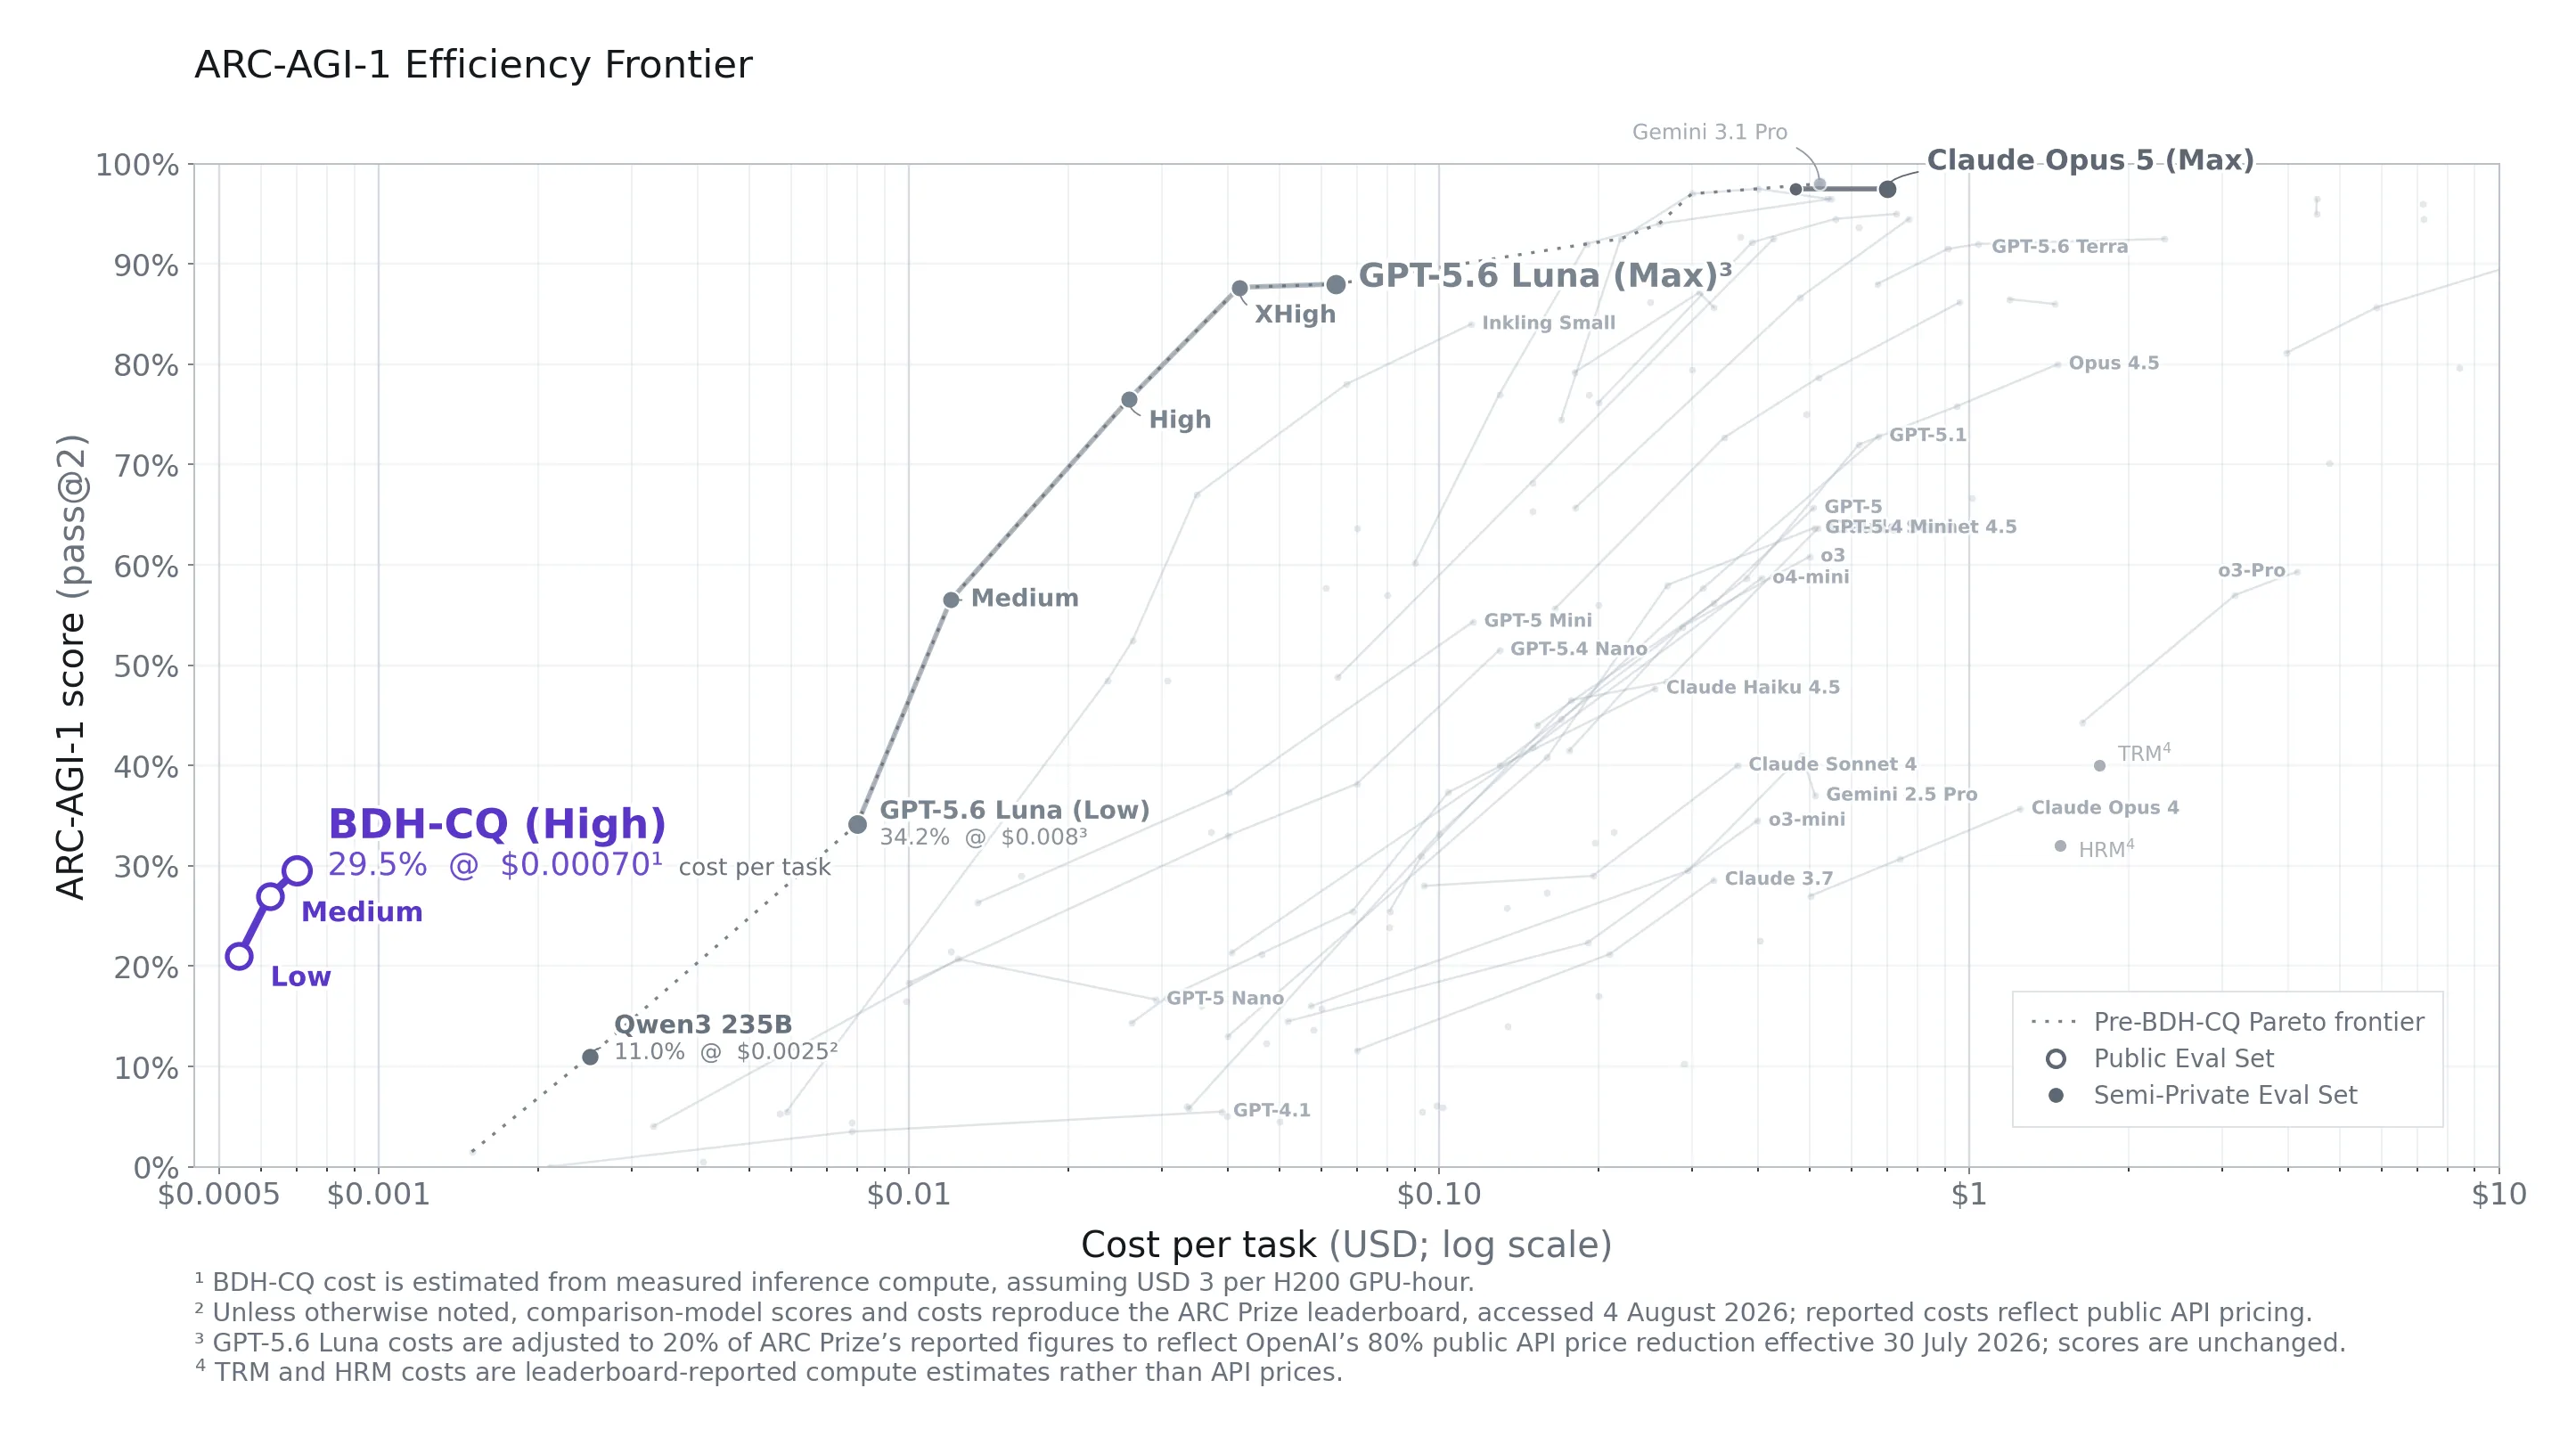
논문 Figure 2. ARC-AGI-1 score versus computed cost per task. 왼쪽 가장자리 마크가 29.5 pass@2. 기존 cost–accuracy Pareto를 뚫는 지점이라는 논문 클레임. 축·각주가 인하 반영(post-cut)이면 본문 57×(pre-cut ARC Prize)와 배수가 갈린다.
남는 건 정확도 1등이 아니라 단가–정확도 전선이다. Luna 34.2%는 여전히 위고, BDH-CQ는 그 아래 정확도대에서 훨씬 싸다는 쪽이다. 숫자 풀이는 아래 “논문 클레임 숫자”로.
ELI5 — 기억 → latent 루프
Figure 1·2는 과제와 전선이다. 여기서는 한 번의 추론만 본다. 데모가 를 갱신하고, 쿼리가 에서 반복된 뒤, 답 그리드만 나온다.
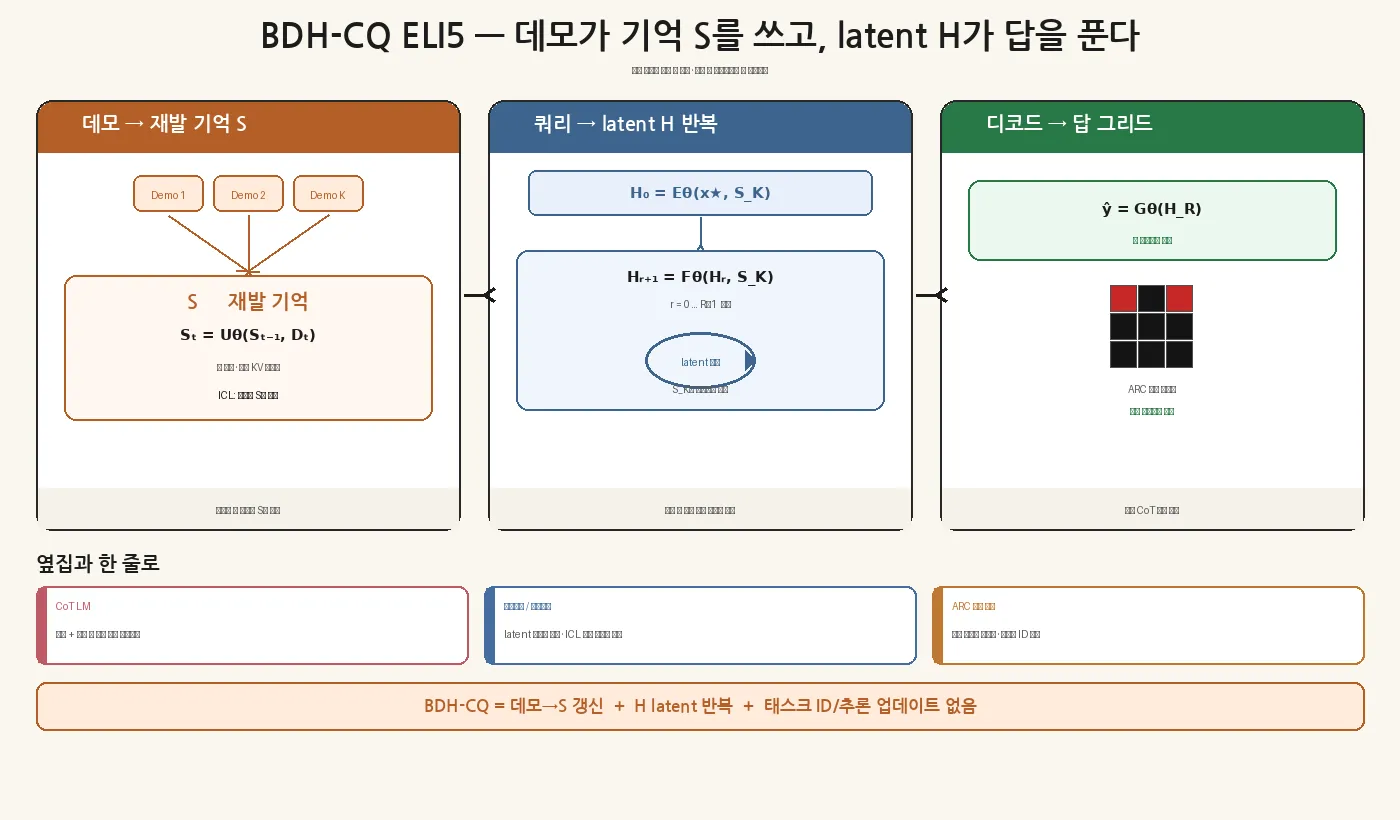
왼쪽 ①: Demo 1…K가 순차로 들어와 — 고정, 명시 KV는 안 키운다. 가운데 ②: 뒤 를 번 — 말로 안 풀고 연속 상태만 돌린다. 오른쪽 ③: 로 답 그리드만 디코드. 하단 세 칸: CoT LM / 연속생각·재발깊이 / ARC 재귀 솔버 — 갈리는 축은 “추론 시 데모만으로 규칙을 에 쓰느냐”.
흐름은 “데모 → 기억 → latent 반복 → 디코드”다. 말 스크래치가 아니라 연속 상태가 계산 공간이다. 식의 정확한 차원은 논문이 공개하지 않는다.
데모는 S에, 풀이는 H에서
몸통은 두 상태다.
재발 기억 . 태스크가 데모 와 쿼리 를 줄 때, 데모를 한 벡터로 압축하지 않고 순차로 넣는다.
는 고정이다. 나중에 오는 입력이 보는 정보는 앞 데모에서 쌓인 연관에 의존한다. 논문은 이를 attention / fast-weight / linear-attention류 맥락 연상과 같은 줄로 읽되, 명시 KV 캐시가 커지지 않는 쪽에 둔다. 특수 사례로 도 적는다.
latent 워크스페이스 . 데모 개를 넣은 뒤 쿼리를 푼다.
는 증거가 들어올 때 바뀌는 ICL 쪽이고, 는 지금 쿼리를 푸는 계산 쪽이다. 중간 는 언어로 디코드하지 않는다.
학습·평가 제약. 평가 태스크 데모 쌍과 태스크 ID는 학습에 안 넣는다. 추론 때 파라미터 업데이트 없다. 학습 믹스는 ARC-AGI-1 train, RE-ARC, ConceptARC, ARC-Heavy, ARC-GEN100K 등과 private 큐레이션(논문). 완전한 학습 레시피는 proprietary.
시스템 범위. 논문이 평가한 “BDH-CQ”는 코어 반복만이 아니라 입력 변환·후보 생성·랭킹·추론 파이프라인을 포함한 구성이다. 150M은 그 중 모델 쪽 규모다.
CoT·재귀 솔버와 다른 점
| 축 | CoT LM | 연속생각 / 재발깊이 | ARC 재귀 솔버 (HRM/TRM류) | BDH-CQ |
|---|---|---|---|---|
| 규칙 습득 | 프롬프트 ICL | 대개 약함·다른 축 | 평가 태스크 최적화·태스크 ID 흔함 | 데모→ 갱신 (추론 시) |
| 계산 공간 | 직렬 토큰 | latent 반복 | latent/후보 재귀 | latent 반복 |
| 중간 출력 | 말로 된 스텝 | 보통 비언어 | 비언어 | 비언어 |
| 추론 시 파라미터 | 고정 | 고정 | 태스크별 적응이 파이프라인에 들어오는 경우 많음 | 고정 |
키워드는 “latent”보다 누가 규칙을 어디에 쓰느냐다. CoT는 규칙+계산을 토큰에 같이 올린다. Coconut·recurrent-depth는 계산을 latent로 옮기되, 이 논문이 강조하는 demonstration-conditioned schema와는 축이 다르다. HRM/TRM은 ARC에서 강하지만, 평가 태스크를 backward-pass로 적응시키는 구성과 대비된다. BDH-CQ는 컨텍스트 기록이 곧 적응이라고 주장하는 쪽에 가깝다.
논문 클레임 숫자
아래는 논문·abstract에 적힌 클레임이다. 독립 재현 전에는 잠정으로 둔다. 새 벤치 숫자는 만들지 않았다.
- 150M 파라미터 구성.
- 공개 ARC-AGI-1 eval 29.5% pass@2 (118/400; Wilson 95% [25.24, 34.15]).
- 측정 추론 ~0.85 H200 GPU-sec/task → 0.00070/task.
- ~57× (pre-cut 가격표). ARC Prize가 보고한 GPT-5.6 Luna (Low) **34.2% @ ~0.00070 → 논문 abstract·본문의 ~57× 저렴 클레임. 이 배수는 ARC Prize 보고가를 쓴다.
- ~11× (post-cut 가격표). OpenAI Luna 80% API 인하(2026-07-30) 뒤 단가가 원래의 20%(~$0.008)로 잡히면 같은 비교는 **~11×**로 줄어든다(논문). ARC Prize 2026-08-06 스냅샷에는 이 인하가 아직 안 실렸다고 적는다. Figure 2 주석·축이 이 조정가를 쓰면, 차트에서 읽히는 배수와 본문 57×는 다른 가격표다.
- ConceptARC(semantic): task pass@2 59.38%, pair pass@2 77.92% — pair↔strict 갭이 “한 입력만 맞춘” 사례를 드러낸다(논문).
- 노력 스케일(표 5): HIGH 29.5% / MEDIUM 27% / LOW 21%(논문). latent reasoning effort를 키우면 pass@2가 오른다는 클레임.
- Bielik·NYU 공저자 black-box 감사가 배포 시스템 29.5%를 재현했다고 보고(가중치 미접근 프로토콜).
단가 전선 돌파는 동일 정확도대에서 더 싼 점을 말하는 것이지, 절대 정확도 SOTA가 아니다. Luna 34.2%는 여전히 위다. 배수를 말할 때는 pre-cut(57×)인지 post-cut(~11×)인지를 같이 붙여야 한다.
남는 한 줄
- 데모→, 쿼리→ — ICL 기억과 latent 실행을 한 파이프에 붙인다. 중간은 말로 안 푼다.
- 승부처는 점수 꼭대기가 아니라 ARC-AGI-1 cost–accuracy 전선 (29.5% @ $0.00070 클레임).
- 옆집은 CoT(직렬 토큰), Coconut/재발깊이(latent만), HRM/TRM(평가 태스크 적응) — 갈리는 축은 추론 시 데모만으로 규칙을 쓰느냐.
- Luna 배수: 57× = ARC Prize pre-cut(~0.008) — Figure 2와 본문을 같은 표로 읽지 말 것.
아직 안 닫힌 것
- ··차원·후보 랭킹이 proprietary라, “재발 기억 + latent” 서사를 독립 구현으로 재현할 수 있는가.
- 29.5% / 가 하드웨어·배치·전처리 가정에 얼마나 민감한가. Luna 가격표(ARC Prize pre-cut vs API post-cut)에 따라 57×↔11×가 갈린다.
- ConceptARC pair vs strict 갭 — 규칙을 붙였는지, 입력별로 맞춘 건지.
- ordering·nesting·composition 경계(논문 §6)가 스케일·데이터로 어떻게 이동하는가.
- 언어·수학·제약만족으로 같은 + 인터페이스가 일반화되는가(outlook). 지금은 ARC-visual 중심이다.