모델이 새 사실을 파라미터 안에 쌓아야 하고, 예전 예시는 다시 못 보고, 추론 때 태스크 ID도 안 준다. 프롬프트나 RAG가 아니라 가중치가 기억이어야 하는 설정이다. 논문 (1)은 이 설정을 long-horizon memorization이라 부른다. 익숙한 이름으로는 catastrophic forgetting이지만, 여기서의 가설은 조금 다르다. 잊는 원인이 한 가지가 아니면, 붙잡는 메커니즘도 보완적으로 합쳐야 한다는 것이다.
한 줄로 남기면 이렇다. 100개 QA 태스크를 순서대로 SFT할 때, 한 가지 연속학습 트릭만으로는 거의 다 잊는다. 데이터·함수·가중치 앵커를 같이 걸고, 태스크마다 LoRA를 머지한 뒤 새로 까는 조합이 단독보다 retention을 크게 올린다(논문 클레임).
어디서 왔나
설정은 domain-incremental이다. Symbol-QA, LLM-QA, Real-QA 각 100개 태스크를 순서대로 supervised fine-tuning(SFT)하고, 예전 예시를 담은 raw replay buffer도, 추론 시 태스크 ID도 없다. 기억이 가중치 안에만 남아야 한다.
계보를 붙이면 “한 방 새 알고리즘”이 아니라 메커니즘 레고에 가깝다. 데이터를 붙잡는 쪽은 generative replay(Shin et al.), 함수(출력 분포)를 붙잡는 쪽은 Learning without Forgetting(Li & Hoiem), 가중치를 붙잡는 쪽은 EWC(Kirkpatrick et al.)·SI류다. Compose-CL (2)은 이 세 축을 한꺼번에 걸고, 업데이트 자리로는 shared LoRA 대신 merged LoRA(태스크마다 머지 후 재초기화, ReLoRA식)를 얹는다.
옆집과 갈린다. Dream-RSI는 하네스 쪽 RSI(탐색·리플레이 트리)이고, 여기는 가중치 안 기억의 연속 SFT다. FWA/continual 레인, LoRA merge-reinit 계보와 이웃이다.
retention이 버티는 그림
흐름은 셋이다. 무엇을 붙잡을지(anchors), 어디에 업데이트를 둘지(low-rank), 그리고 memory age에 따라 retention이 어떻게 버티는지.
flowchart TB
  problem["100-task SFT · 예전 예시 없음 · task ID 없음"]
  problem --> anchors["Anchors: Data / Function / Weight"]
  problem --> lora["Low-rank: Shared vs Merged LoRA"]
  anchors --> compose["Compose-CL 조합"]
  lora --> compose
  compose --> out["retention ↑ · 일반 능력은 별개"]
논문 Figure 1 — memory age에 따라 retention이 어떻게 버티는가
왼쪽부터 보면 된다. 패널 셋은 Symbol-QA / LLM-QA / Real-QA이고, 가로축은 memory age(태스크 수), 세로축은 retention(로그 스케일)이다. 회색 점선이 naive, 주황 점선이 best single, 초록·파랑이 조합 쪽이다. (프로젝트 원문 2)
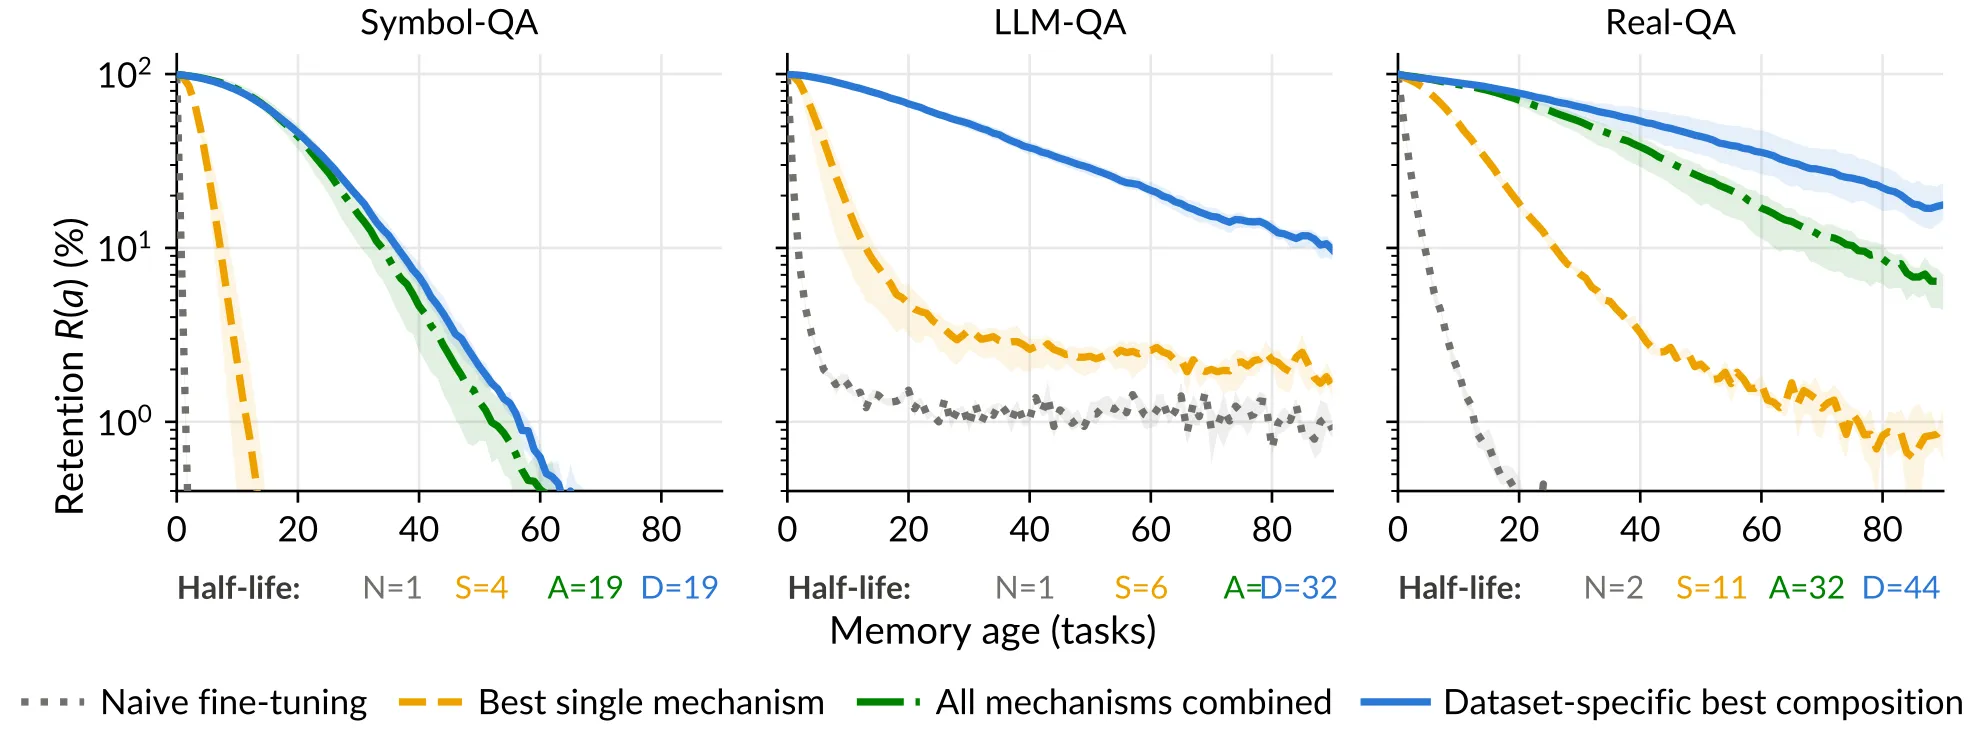
왼쪽 Symbol-QA: naive(회색, half-life N=1)는 곧바로 바닥으로 떨어지고, best single(주황, S=4)도 빠르게 꺾인다. all combined(초록)와 dataset-specific best(파랑)는 거의 겹치며 half-life A=D=19까지 버틴다. 가운데 LLM-QA: naive·single은 낮은 구간에 머물고, 조합(파랑·초록, A=D=32)만 긴 age에서도 한 단 위에 남는다. 오른쪽 Real-QA: 네 선이 가장 또렷이 갈린다. naive(N=2) → single(S=11) → all combined(A=32) → dataset-specific best(D=44). 밴드는 3-seed min–max다.
여기서 보면 된다. naive는 half-life 1–2 태스크에서 무너지고, 단독 최고도 한 자릿수 구간에 머문다. 조합이 수배~수십 배로 버티는 쪽이다(논문 클레임). Real-QA처럼 네 선이 갈리는 패널을 먼저 보면 “합치는 이득”이 가장 잘 보인다. 아래 숫자들은 논문·skim 클레임이니, 일반 능력 붕괴와는 별개로 읽어야 한다.
| 구분 | avg final retention (논문 클레임) | half-life (태스크 수) |
|---|---|---|
| Naive sequential SFT | 1.2% | 1–2 |
| Best single mechanism | ~8.1% | 4 / 6 / 11 (셋별) |
| Best composition (세 앵커 + merged LoRA) | 34.9% (~28× vs naive) | 19 / 32 / 44 (셋별) |
앵커와 LoRA가 하는 일
설계 축은 둘이다. 무엇을 붙잡을지(anchors), 어디에 업데이트를 둘지(low-rank allocation).
Anchors. Data anchor는 이전 모델로 가짜 시퀀스를 만들어 리플레이한다(generative replay). 예전 예시를 보관할 수 없으니, 모델이 기억한 것처럼 보이는 데이터를 다시 먹인다. Function anchor는 지금 태스크 입력에서 이전 모델의 출력 분포를 따라가게 한다(Learning without Forgetting / self-distillation). 같은 질문이면 예전 답 분포를 잊지 말라는 뜻이다. Weight anchor는 중요한 파라미터를 덜 움직이게 한다(EWC·SI류 importance regularization). 예전에 쓰던 가중치를 너무 덮어쓰지 말라는 장치다.
Low-rank allocation. Shared LoRA는 태스크가 바뀌어도 같은 어댑터 A, B를 계속 학습한다. 하나 위에 계속 덮어쓴다. Merged LoRA는 태스크 t의 LoRA를 dense 가중치에 접어넣고, 다음 태스크는 새 LoRA와 새 옵티마이저로 시작한다. ReLoRA식 merge-and-reinit을 continual에 옮긴 형태다. 상태 크기는 태스크 수에 안 늘고 상수로 남는다. 실험에서 승자 쪽에 가깝다.
목적함수 스케치는 논문 Eq.2다. 현재 태스크 SFT 손실에 세 앵커 정규화를 더한다.
Θ_t = argmin L_SFT + R^D + R^F + R^W
조합 후보는 task-level successive halving으로 걸러낸 뒤, 앵커 × merged LoRA의 2⁴ factorial로 주효과와 교호작용을 본다.
Dream-RSI·O-LoRA와 다른 점
Dream-RSI는 하네스에서 탐색·리플레이 트리를 돌린다. 가중치 안에 사실을 쌓는 이야기가 아니다. Compose-CL은 가중치 기억의 연속 SFT이고, 잊는 축이 여럿이면 붙잡는 축도 합친다는 쪽에 가깝다.
O-LoRA 등은 retention은 비슷해도 일반 능력 보존이 더 낫다고 보고한다. 같은 “연속학습” 키워드라도, 여기서 보는 축은 retention이고 그쪽은 retention–일반능력 트레이드오프의 다른 지점이다.
논문 클레임 숫자
재료에 적힌 것만. 독립 재현 전에는 잠정이다. 베이스는 저자들이 만든 100-task memorization 셋이다.
- Naive sequential SFT 평균 final retention 1.2% → best composition(세 앵커 + merged LoRA) 34.9%. 약 28× 개선 주장.
- Best single mechanism 평균 final ~8.1%. 조합이 단독을 크게 앞선다고 주장.
- Memory half-life(retention이 절반으로 떨어질 때까지의 태스크 수): naive 1–2 → best single 4 / 6 / 11 → best composition 19 / 32 / 44(셋별) 주장.
- Factorial에서 data anchor(replay) 와 merged LoRA 가 주효과 최대. 둘의 상호작용은 세 데이터셋 모두 super-additive(합친 이득 > 단독 합)라고 주장.
- 데이터셋별 peak composition은 조금 다르지만, “세 앵커 + merged LoRA”만 세 셋 모두 top-3에 들어간다고 보고.
한계도 논문에 적혀 있다. retention이 올라도 GSM8K / MATH / MMLU류 일반 능력은 여전히 크게 까먹는다. O-LoRA는 retention은 비슷해도 일반 능력 보존이 더 낫다고 보고한다.
남는 한 줄
- Long-horizon memorization에서는 한 메커니즘만으로는 거의 다 잊는다. 잊는 축이 여럿이면 붙잡는 축도 합쳐야 한다.
- Data·function·weight 앵커와 merged LoRA(머지 후 재초기화)를 같이 쓰는 조합이 단독을 크게 앞선다는 논문 클레임이다. replay와 merged LoRA가 주효과·초가산 상호작용의 중심이다.
- Retention이 올라도 일반 능력 붕괴는 별개 문제다. O-LoRA 등이 retention–일반능력 트레이드오프에서 다른 지점을 잡을 수 있다.
아직 안 닫힌 것
- Retention↑이 GSM8K/MATH/MMLU류 일반 능력 붕괴를 얼마나 막는가. 논문도 아직 많이 까먹는다고 적는다.
- 어느 조합이 벤치·모델 패밀리를 넘어 옮아가는가. 셋별 peak가 다르다는 보고가 이미 있다.
- Merged LoRA의 merge-reinit이 shared LoRA 대비 어디서 인과적으로 이기는가(상태 상수 vs 표현 용량).
- O-LoRA처럼 retention은 비슷하고 일반 능력만 더 지키는 축을 Compose-CL 조합에 어떻게 섞을지.
- Successive halving + factorial 탐색이 더 큰 모델·더 긴 태스크 열에서도 같은 주효과를 내는가.