LLM 디코딩이 느린 이유는 흔히 “계산이 부족해서”가 아니다. 한 토큰씩 순차로 뽑다 보면 GPU가 놀고, 메모리 대역폭에 묶인다. 그래서 나온 우회가 초안을 먼저 쓰고, 본 모델이 한 번에 검사하는 speculative decoding이다. 초안이 맞으면 여러 토큰이 한꺼번에 확정되고, 틀리면 그때부터 다시 본 모델이 이어 쓴다. 출력 분포는 본 모델과 같게 맞출 수 있다.
문제는 초안을 누가 쓰느냐다. 작은 draft 모델을 따로 두거나(EAGLE류), 본 모델에 머리를 붙이는 방식은 서빙에 짐이 남는다. Uno가 묻는 것은 이것이다. 초안까지 같은 몸 안에서 끝내고, 검사만 본래 AR에 맡기면 안 될까?
답은 Ψ-Spec이다. 확산 경로가 여러 토큰을 한꺼번에 제안하고, 동결된 AR이 앞에서부터 연속으로 받을 수 있는 구간만 남긴다. 거절이 난 자리부터는 AR이 다시 이어 간다. 최종 출력 분포는 베이스 AR과 같다. 논문이 말하는 lossless다.
한 줄로 남기면 이렇다. AR은 법전이고, LoRA 확산은 초안이며, Ψ-Spec은 법전에 맞는 가장 긴 구간에만 도장을 찍는다.
어디서 왔나
이 노트만 보면 “확산 + LoRA”로 보이기 쉽다. 계보를 붙이면 위치가 달라진다.
출발점은 Leviathan et al. (2023)이다. 작은 draft가 먼저 토큰을 제안하고, 본 모델이 한꺼번에 검사한 뒤, 거절된 지점부터는 본 모델 분포로 다시 맞춘다. 나중에 원저자들이 쓴 회고가 이 흐름을 가장 또렷하게 풀어 둔다. (위키: Speculative Decoding)
그다음 질문은 초안을 어떻게 값싸게 만드느냐다. Medusa는 별도 draft 모델을 버리고 디코딩 헤드를 붙였다. (Together: Medusa, 위키: Medusa, HF TGI Speculation) EAGLE은 feature-level draft로 accept를 올렸고, EAGLE-3·DFlash는 그 연장선이다. (위키: EAGLE, EAGLE-3, HF: EAGLE3 in practice) 공통점은 draft→verify라는 역할 분담이고, 차이는 draft를 어디에 두느냐다. 허브 요약은 빠른 추론.
Uno는 그 주소를 이렇게 푼다. draft를 같은 모델의 LoRA 확산 경로에 두고, 품질 기준은 끝까지 동결 AR에 묶는다. 순수 diffusion LLM처럼 생성 전체를 확산에 맡기지 않는다.
몇 달 앞선 Orthrus(2026-05, 2605.12825)도 같은 식으로 역할을 나눈다. shared KV 위에 가벼운 diffusion head로 초안을 뽑고, AR이 검사한다. 다만 Orthrus PDF에 Uno 언급은 없고, Uno PDF에도 Orthrus 인용은 없다. 서로 직접 인용하지 않은 동시발 형제다. 둘 다 EAGLE-3·DFlash를 “외부 drafter + 이중 KV”로 두고, 자신은 shared KV 위 내부 draft에 둔다. Orthrus §4.4는 diffusion head가 AR과 같은 KV를 쓰니 외부 drafter·중복 캐시가 없다고 적고, Uno Related Work / Takeaway 4는 단일 아키텍처·단일 KV라 추가 파라미터와 피크 메모리가 적다고 적는다.
LAD는 LoRA·확산 키워드가 겹치지만, 전체를 denoise하는 다른 이야기다. (아래 “Orthrus·LAD·EAGLE과 다른 점”에서 다시 적는다.)
참고로 Lilian Weng의 2023-01 inference 글은 양자화·병렬·attention 압축 쪽이라, speculative 계보 허브로는 여기 붙이지 않는다.
학습·추론 그림
그림을 세 장으로 나눈다. 먼저 학습이 어디에 끼어드는지, 그다음 추론 때 draft→verify가 어떻게 도장을 찍는지, 옆집 비교는 아래 “Orthrus·LAD·EAGLE과 다른 점” 절에서 다시 본다.
논문 Figure 1 — 어디에 끼워 넣는가, 무엇이 빨라지는가
위부터 보면 된다. 위쪽 타임라인은 “새 베이스를 처음부터 만들지 않는다”는 쪽이고, 아래쪽 막대는 “빨라져도 AR 점수는 안 깨진다”는 쪽이다. (프로젝트 원문)
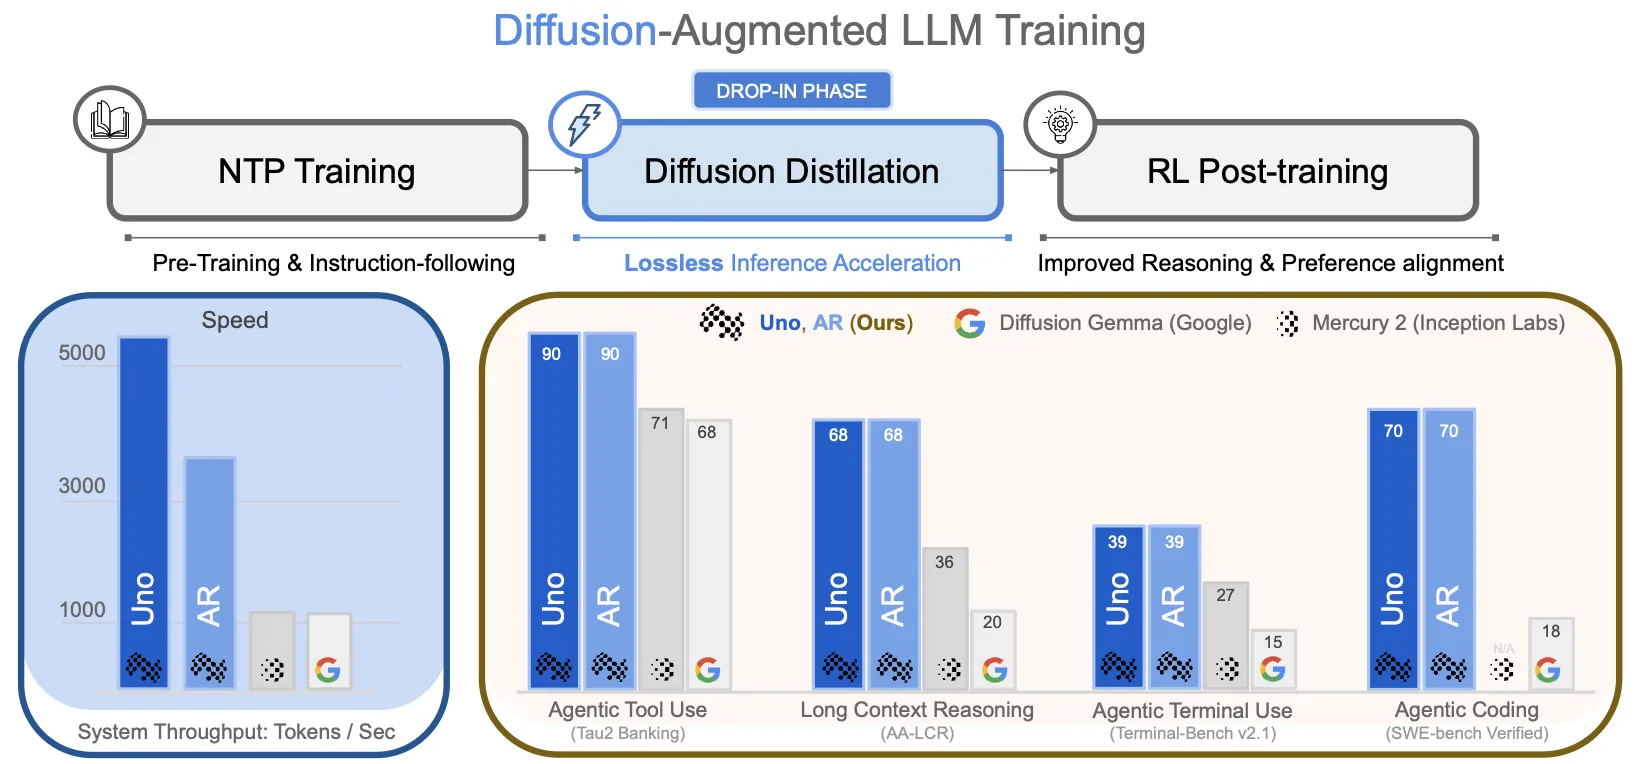
위 패널: NTP(다음 토큰 예측)로 AR을 만든 뒤, Diffusion Distillation을 drop-in으로 얹고, 필요하면 RL로 이어간다. 가운데 파란 칸이 Uno가 끼는 자리 — 별도 초안 모델 없이 가속 경로만 얹는다는 그림이다. 아래 왼쪽: System Throughput(토큰/초). Uno 막대가 AR·Mercury 2·Diffusion Gemma보다 높다(논문 클레임). 아래 오른쪽: Agentic Tool Use / Long Context / Terminal / SWE-bench. Uno와 AR 막대 높이가 같다 — lossless(품질이 베이스 AR과 같다)를 숫자로 보여 주려는 장치다. 경쟁 d-LLM 쪽은 같은 축에서 더 낮다.
여기서 보면 된다. Uno는 학습 파이프라인의 가운데 한 칸이지, AR을 대체하는 새 모델이 아니다. 속도 막대만 보지 말고 Uno와 AR 점수가 같은지도 같이 보라. 막대만 높고 점수가 갈라지면 lossless 이야기가 깨진다. 아래 숫자들은 논문·skim 클레임이니, 서빙 wall-clock은 아직 따로 봐야 한다.
Ψ-Spec ELI5 — 추론 때 초안이 어디서 나오고, 어디서 잘리는가
위 Figure 1은 학습·벤치 조감도다. 여기서는 한 번의 생성 스텝만 본다. 동결 AR이 품질을 잠그고, LoRA 확산이 블록을 제안하며, AR rejection이 연속으로 맞는 prefix만 남긴다.
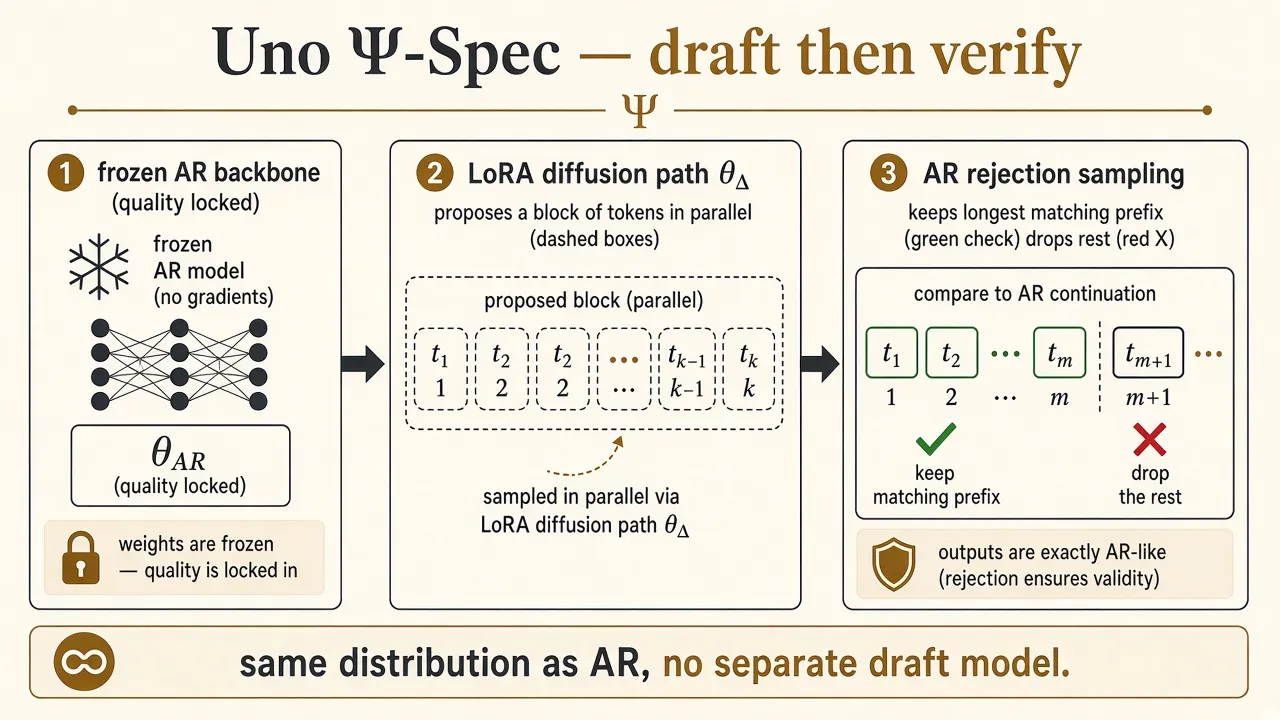
왼쪽: 동결 AR(θ_AR) — 가중치를 안 건드린다. 가운데: LoRA 확산 경로(θ_Δ)가 토큰 블록을 병렬로 제안한다(점선 칸). 오른쪽: AR이 앞에서부터 비교해 가장 긴 일치 prefix만 남기고(초록), 어긋난 뒤는 버린다(빨강). 하단 한 줄: 별도 draft 모델 없이, 출력 분포는 AR과 같다.
흐름은 “초안 → 검사 → 잘림”이다. 초안이 길어도 검사는 앞에서부터고, 한 번 거절이 나면 그 뒤는 통째로 못 쓴다. accept가 길수록 이득이 크고, 배치·긴 컨텍스트에서 accept가 짧아지면 위 Figure 1의 속도 막대도 그대로 믿기 어렵다. 메커니즘은 바로 아래에서 이어진다.
Ψ-Spec이 한 스텝에서 하는 일
몸 안에 길이 둘이다.
θ_AR 은 다음 토큰 예측(NTP)로 학습한 AR 경로다. Uno는 이를 동결한다. 추론에서 정답 분포이자 최종 검사관이다.
θ_Δ 는 레이어마다 붙인 LoRA다. 본 AR 가중치는 건드리지 않는다. Diffusion Distillation으로 이 어댑터만 깎아, 여러 토큰을 한꺼번에 제안하게 만든다. 별도 draft 모델이 아니라, 같은 몸 안의 짧은 덧붙임이다.
추론은 Ψ-Spec이다. 확산 경로가 길이 B짜리 후보를 내밀면, AR이 앞에서부터 받아들여도 되는지 본다. 남는 것은 가장 긴 연속 prefix뿐이다. 그 앞까지는 확정이고, 거절이 난 자리부터는 AR이 한 토큰씩 이어 쓴다.
lossless는 “대충 비슷하다”가 아니다. rejection이 분포를 보정해서, 최종적으로는 베이스 AR을 그대로 샘플링한 것과 같아진다는 약속이다. speculative decoding이 처음 걸었던 그 약속과 같다.
Orthrus·LAD·EAGLE과 다른 점
EAGLE·DFlash도 draft→verify다. 갈리는 지점은 초안을 누가 쓰느냐다. 그쪽은 대체로 별도(또는 attach) drafter를 둔다. Uno는 초안을 같은 모델의 LoRA 확산 경로에 둔다.
순수 diffusion LLM과도 다르다. 그쪽은 생성 자체가 확산을 따르므로, 품질이 AR 분포에 묶이지 않는다. Uno는 초안만 확산이고, 품질 기준은 끝까지 AR이다.
HF 타임라인에 같이 뜨는 이름도 짚어 둔다. 아래 세 칸은 역할 분담이 같은지만 먼저 보고, 손대는 자리(헤드 vs LoRA)는 그다음 절에서 본다.
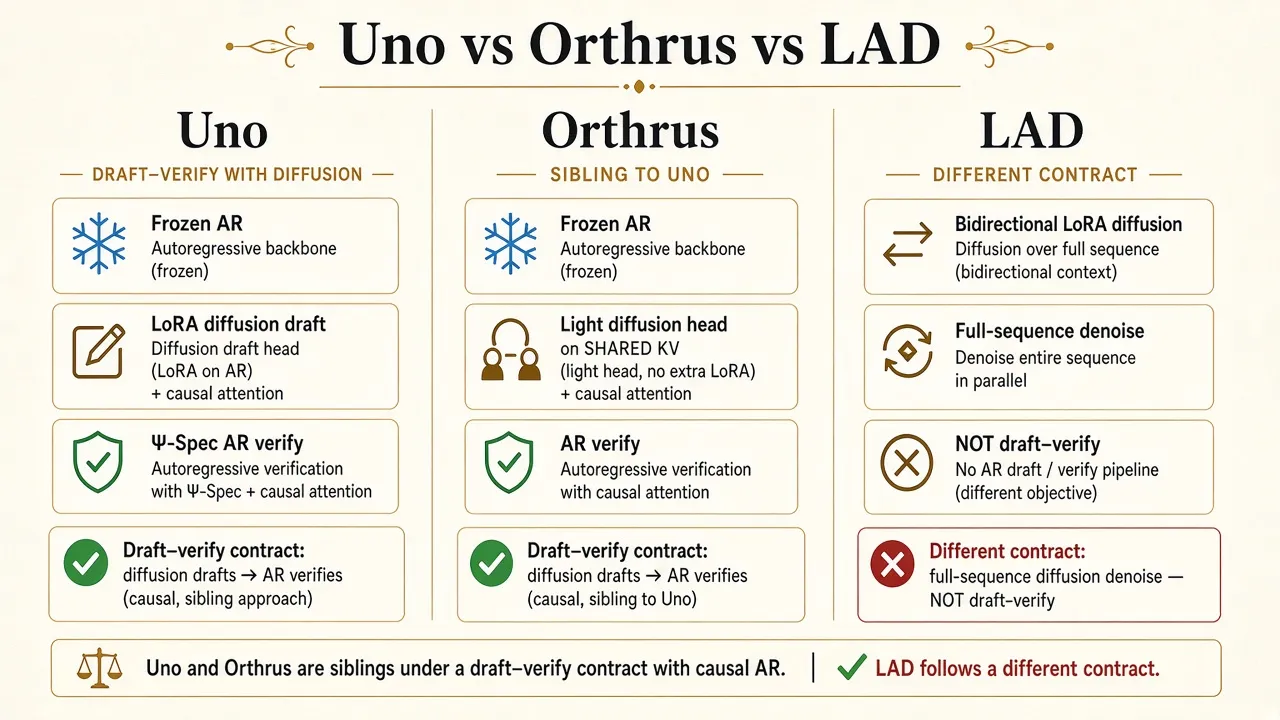
왼쪽 Uno: 동결 AR + LoRA 확산 draft + Ψ-Spec 검사 — draft→verify. 가운데 Orthrus: 동결 AR + shared KV 위 가벼운 diffusion head + AR 검사 — 역시 draft→verify(형제). 오른쪽 LAD: bidirectional LoRA 확산으로 전체 시퀀스를 denoise — draft→verify가 아니다(빨간 X). 하단 요약: Uno·Orthrus는 causal AR 검사라는 같은 약속을 쓰고, LAD는 다른 약속이다.
키워드(LoRA·확산)보다 검사관이 누구인지가 먼저다. Uno와 Orthrus는 둘 다 초안을 확산으로 뽑고 AR이 도장을 찍는다. LAD는 검사관 AR이 없고 전체를 한 번에 깎는다. HF에서 세 이름이 같이 떠도, 이 노트에서는 LAD를 “옆집 표면 유사”로만 둔다.
Orthrus는 Uno와 같은 식으로 역할을 나눈 형제다. 동결 AR, shared KV 위 diffusion head로 K토큰을 뽑고 AR이 검증한다. LAD(EMNLP’25)는 LoRA와 확산을 쓰지만 causal을 bidirectional로 바꿔 전체를 denoise한다. 초안을 내고 AR이 검사하는 흐름이 아니다. 키워드가 겹쳐 HF에서 같이 묶이지만, 하는 일은 이웃 수준이다.
헤드냐, LoRA냐
역할 분담은 같고, 손대는 자리가 다르다.
Orthrus는 레이어마다 확산 attention 헤드(diffusion Q/K/V projection, AR counterpart에서 초기화)만 학습하고 AR은 동결한다. 논문 클레임으로 trainable이 전체의 약 **16%**다. 서빙에서는 AR prefill이 shared KV를 만들고, diffusion head가 그 위에서 K토큰을 병렬 제안한 뒤 AR이 검증·append한다. 히스토리 KV는 한 줄이고, 별도 drafter cache가 없다.
Uno는 각 AR weight에 rank-128 LoRA(θ_Δ)만 깎는다. UnoQwen 클레임으로 +0.35B다. draft는 θ_AR+θ_Δ, verify는 θ_AR만 — gated LoRA로 같은 forward에서 경로를 나눈다. 서빙도 어댑터 on/off로 고르는 PEFT식이다. KV는 마찬가지로 공유 한 줄이다.
언제 무엇을 고르면 될까. dual-view attention을 명시하고 Orthrus 스택을 따를 때는 헤드, 기존 AR 체크포인트에 얇게 얹고 어댑터 스위칭을 우선할 때는 LoRA 쪽이 자연스럽다. 다만 “lossless”를 서빙 숫자만으로 읽지 말 것. BF16에서 Orthrus식 궤적이 갈라질 수 있다는 각주는 materials compile orthrus-numerical-precision (arXiv 2609.15504).
논문 클레임 숫자
아래는 재료에 적힌 논문·skim 클레임이다. 독립 재현 전에는 잠정으로 둔다.
- 평가한 배치에서 leading speculative보다 throughput이 높고, 베이스 AR 대비 최대 약 **3×**다. BS1에서는 약 **2.2×**라는 skim 메모가 있다.
- 8B Uno가 26B DiffusionGemma·Mercury 2를 agentic·coding·long-context에서 앞선다는 논문·skim 클레임이 있다.
제품으로 옮기기 전에 다시 볼 것은 둘이다. vLLM/SGLang wall-clock이 논문 배수와 같은지, 배치를 키웠을 때 accept가 무너지는지. HF 쪽 large-batch 회의가 여기 걸려 있다. 배수만 믿고 옮기기엔 이르다.
서빙에서 아직 비는 것
계보 링크와 Orthrus↔Uno 관계는 채워졌다. 그래도 남는 빈칸은 있다.
- 숫자와 서빙의 간극. 메커니즘은 또렷한데, wall-clock·대형 배치에서의 승리는 아직 미검증이다. 남는 쟁점은 여기다.
- 형제 사이의 체감. 헤드 vs LoRA의 학습·서빙 차이는 적었지만, 벤치·서빙에서 Orthrus 대비 Uno가 얼마나 다른지는 열려 있다.
- 장문 설명글. Orthrus/Uno 자체를 Lilian식으로 풀어 쓴 글은 아직 없다. 위키·회고·실무 글로 계보는 잇되, 이 노트 한 편이 그 장문을 대신하지는 않는다.
남는 한 줄
- 같은 모델 안에서 LoRA 확산으로 초안을 뽑고, 동결 AR이 연속 prefix만 받는다. 별도 drafter 없이 lossless다.
- EAGLE류와 갈리는 점은 초안이 몸 안에 있다는 것, 순수 d-LLM과 갈리는 점은 품질이 AR에 묶인다는 것이다.
- Orthrus는 같은 식으로 역할을 나눈 형제(직접 cite는 없음), LAD는 하는 일이 다르다. 헤드 vs LoRA는 손대는 자리의 차이다. 서빙 숫자와 큰 배치는 아직 회의 구간이다.
아직 안 닫힌 것
- 논문 throughput이 실서빙 시계에서도 그대로인가.
- 배치를 키우면 accept·이득이 어떻게 꺾이는가. 꺾이면 “~3×” 서사는 BS1 근처로 좁혀야 한다.
- Orthrus 대비 Uno의 체감 이득이 벤치·서빙에서 얼마나 다른가.
- 긴 컨텍스트·높은 동시성에서 accept가 붕괴하면, 위키에 적힌 draft–verify 실패 모드와 같은 독인가.