Random Attention이 “똑똑한 KV 점수는 거의 안 먹힌다”를 보여 준 뒤에도, 긴 CoT에는 다른 실패가 남는다. 최근 쿼리만으로 과거 KV를 고르면, 초반 계획·문제문을 다시 보는 순간이 깨진다. “방금 쓴 문장만 보면 된다”는 가정이 여기서 틀어진다.
BeaconKV (1)는 그 순간을 Thought Revisiting Tokens(TRT) 로 잡는다. 과거 KV에 ‘중요했음’ 점수를 붙이는 대신, 나중에 다시 올 쿼리의 방향(beacon) 을 남긴다. Random Attention을 부정하지 않는다. 점수에 집착하지 말라는 결론 다음에, 다시 볼 구조만 골라 남기는 다음 글이다.
한 줄로 남기면 이렇다. 멀리 다시 볼 쿼리는 몇 덩어리로 모이니, 그 대표(beacon)와 최근 구간만 지켜도 Thought Revisiting을 살릴 수 있다.
Random Attention 다음 단계
읽기 순서는 Random Attention → 이 글이다. 앞에서 “점수에 집착하지 말라”를 받아들인 뒤, 여기서는 “그래도 다시 볼 모양은 남겨라”만 집어 올린다. eviction 줄의 앞 타일이 프롬프트 보호+랜덤을 말했고, 이 타일은 far-revisit 기하만 남긴다.
SWA+고정 sink와도 갈린다. 그쪽은 최근 윈도와 맨 앞(또는 고정 위치) sink다. BeaconKV의 beacon은 디코드가 진행되는 동안 바뀐다. 고정 자리가 아니라, 지금 쿼리 분포를 커버하는 대표다.
같은 레인 허브는 긴 컨텍스트 단가다. Gated DeltaNet은 recurrent compression 길이고, 이 글은 eviction 줄(Random Attention → BeaconKV)에 속한다.
TRT와 beacon의 흐름
그림을 위→아래로 읽는다. 먼저 무엇이 깨지는지(TRT), 그다음 어디에 모이는지(pre-RoPE 클러스터), 마지막에 무엇을 남기는지(observation set).
ELI5 — Thought Revisiting이 어디서 나오고, beacon이 무엇을 남기는가
위 패널은 긴 CoT 타임라인이다. 최근 토큰이 초반 계획·문제문을 다시 보는 화살표가 TRT다. 가운데는 그 쿼리가 pre-RoPE에서 소수 클러스터로 모이고, Continual FPS가 별(beacon)을 고르는 장면이다. 아래는 최근 쿼리+beacon으로 observation set을 만들고, max-aggregate로 KV를 남기거나 버리는 흐름이다.
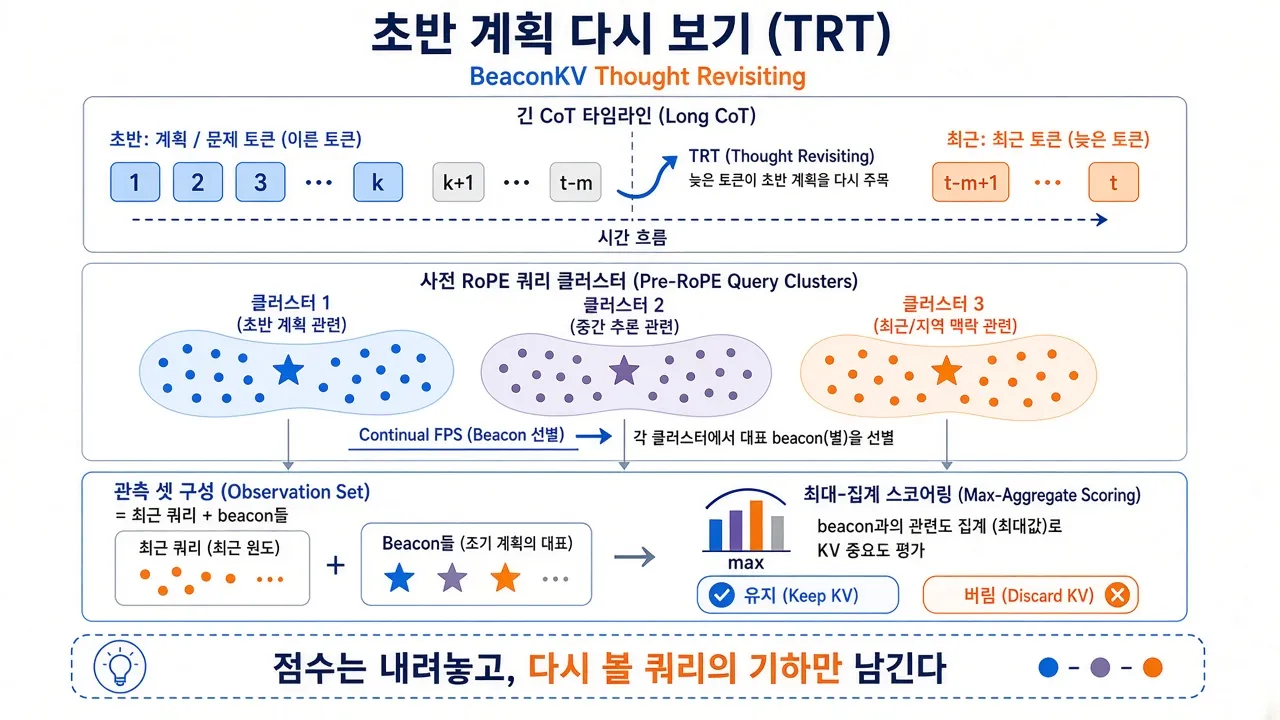
위 패널: 긴 CoT 타임라인. 왼쪽 초반(계획·문제)에서 오른쪽 최근으로 시간이 흐르고, 최근 토큰이 초반으로 되돌아가는 파란 곡선이 TRT(Thought Revisiting)다. 가운데: pre-RoPE 쿼리 점이 초반 계획·중간 추론·최근 맥락 등 소수 클러스터로 모이고, Continual FPS가 각 클러스터에서 별(beacon)을 고른다. 아래 왼쪽: 최근 윈도 쿼리와 beacon을 합쳐 observation set을 만든다. 아래 오른쪽: 그 위에서 attention을 max-aggregate해 KV 점수를 만들고, budget 밖은 버린다(유지 ✓ / 버림 ✕). 하단 한 줄: 점수는 내려놓고, 다시 볼 쿼리의 기하만 남긴다.
흐름은 “다시 보기 → 클러스터 → 대표 → 남김/버림”이다. 과거 KV에 ‘중요했음’을 붙이지 않고, 나중에 올 쿼리의 모양만 남긴다. accept(남김)이 길수록 이득이고, TRT가 드문 태스크에서는 beacon 갱신 이득이 얇아질 수 있다. 메커니즘은 바로 아래 “무엇이 돌아가는가”에서 이어진다.
| 구분 | Random Attention | BeaconKV |
|---|---|---|
| 앞 글이 말한 것 | 점수에 집착하지 말라 (프롬프트만 지키면) | 그래도 다시 볼 쿼리의 모양은 남겨라 |
| 남기는 것 | 프롬프트 전부 · reasoning은 랜덤 | beacon + 최근 윈도 |
| 버리는 신호 | 없음 | 최근 쿼리 + beacon 위 attention (max-aggregate) |
| sink와의 차이 | (해당 없음에 가깝다) | 고정 sink가 아니라 디코드 중 갱신되는 beacon |
메커니즘 상세
실패부터 잡는다. 최근 쿼리만으로 과거 KV에 점수를 주면, “지금 안 쓰이지만 나중에 TRT가 다시 찾을” 초반 KV가 잘린다. 과거 중요도 점수든 Random Attention의 점수 없음이든, 다시 볼 쿼리의 모양을 명시하지 않으면 이 실패를 놓친다.
BeaconKV는 학습이 없다. 추론 때 압축 규칙만 바꾼다. 흐름은 셋이다.
첫째, pre-RoPE 공간이다. Rotary Position Embedding을 걸기 전의 query 표현이다. 논문 관찰에 따르면 TRT의 global query가 여기서 소수 클러스터로 모인다. 위치 회전 전에 “무엇을 다시 볼지”의 방향이 보인다.
둘째, Continual FPS로 beacon을 고른다. 이미 고른 점에서 가장 먼 점을 반복 선택해 커버리지를 유지하고, 디코드가 진행되면 beacon 집합을 갱신한다. 고정 sink와 대비되는 지점이다.
셋째, observation set이다. 최근 쿼리와 beacon을 합친 집합이다. 이 위에서 attention을 max-aggregate해 KV 점수를 만들고, budget 밖은 버린다. 최근 윈도는 항상 남긴다. 전체 과거 쿼리를 다 보지 않고도 far-revisit을 근사하려는 장치다.
한 문장으로 남기면, 과거 KV에 ‘중요했음’을 붙이지 말고 다시 볼 쿼리의 모양을 남겨라.
Random Attention과 어떻게 이어지나
Random Attention은 프롬프트 전체를 지키고 reasoning에는 eviction 신호가 없다. BeaconKV는 beacon과 최근 윈도를 남기고, observation set으로 신호를 만든다. 모순이 아니라 이어짐이다. 점수에 집착하지 말라는 결론 다음에, TRT 구조만 골라 남긴다.
논문 클레임 숫자
재료에 적힌 것만. 독립 재현 전에는 잠정이다. 커뮤니티도 아직 얇다 (9/11 skim ↑32).
- 오픈 LRM 4종 · 다양한 reasoning 벤치.
- 최대 약 5.8× 메모리 절감, full-cache 정확도 거의 유지, throughput >4.3×.
벤치별 표는 이 노트에 없다. 메모리 배수와 wall-clock은 별개다. Continual FPS 갱신 주기와 beacon 개수가 서빙 latency에 미치는 벽은 열려 있다.
남는 한 줄
- 긴 CoT의 숨은 실패는 최근 쿼리만 보는 것이다. Thought Revisiting이 잘린다.
- 남길 것은 과거 KV 점수가 아니라 다시 볼 쿼리의 모양 — pre-RoPE 클러스터, Continual FPS, observation set.
- Random Attention과 이어진다. 점수에 집착하지 말라는 다음 단계로 TRT 구조만 남긴다. beacon은 고정 sink가 아니라 디코드 중 갱신된다.
아직 안 닫힌 것
- TRT·pre-RoPE 클러스터가 모델 패밀리·스케일마다 같은 모양인가.
- beacon 없이 최근 윈도+프롬프트만으로도 같은 벤치가 버티면, beacon의 인과가 약해진다.
- Random Attention 위에 beacon만 얹는 조합이 어디서 이기는가.
- Continual FPS 주기·beacon 개수가 서빙 latency에 미치는 영향.
- TRT가 드문 태스크에서도 갱신 beacon이 SWA+고정 sink를 이기는가.